Wat er concreet misgaat, en waarom het escaleert
De problemen met ongecontroleerde AI-adoptie zijn niet hypothetisch. Ze zijn al zichtbaar in organisaties die twee jaar geleden nog dachten dat ze de vinger aan de pols wilden houden, wat geïsoleerde pilots deden maar nog steeds geen duidelijke visie hebben uitgewerkt. Dit is wat er in de praktijk gebeurt:
Datafragmentatie
Elke medewerker voedt zijn AI-tool met de data die hij zelf kan vinden: exports, screenshots, kopieerwerk. De output is gebaseerd op bronnen die mogelijk niet (meer) kloppen, niet actueel zijn, en vooral niet traceerbaar zijn.
Shadow IT op schaal
Vibe-coded agents, lokale automatiseringen en browser-extensies worden gebouwd zonder enige betrokkenheid van IT. Ze werken … tot ze niet meer werken, en niemand weet waarom of hoe ze te repareren.
Compliance-blinde vlekken
Gevoelige data zoals klantgegevens, personeelsdossiers, juridische documenten worden gedeeld met externe AI-diensten zonder dat er een verwerkersovereenkomst is, laat staan een data-classificatiebeleid.
Inconsistente output als nieuwe norm
Twee medewerkers die dezelfde vraag stellen aan twee verschillende tools, krijgen twee verschillende antwoorden. Niemand weet welk klopt. Langzaam sluipt onzekerheid in besluitvorming omdat wat ooit feitelijk was, nu onderbouwd is door verschillende tools met verschillende uitkomsten.
Onoverbrugbare technische schuld
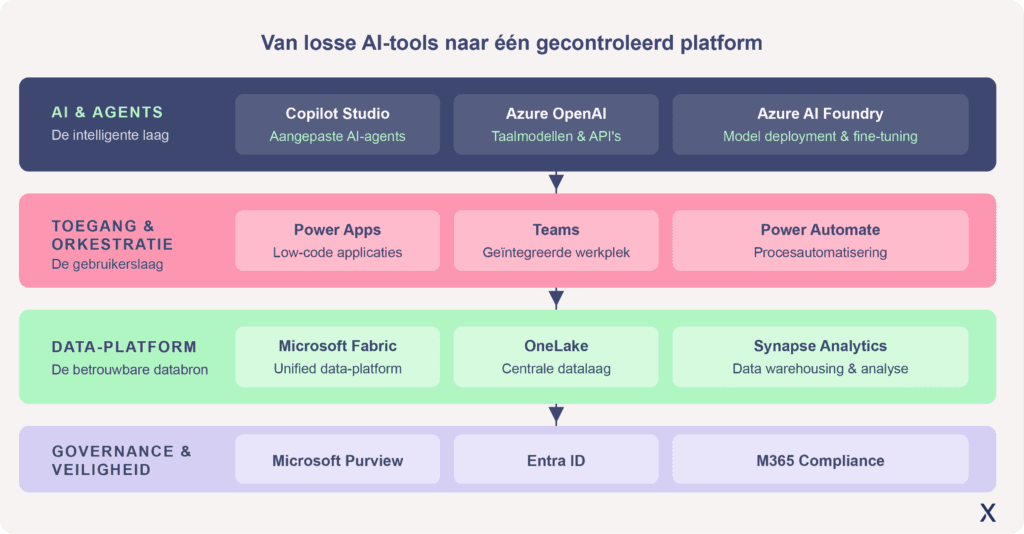
Elke lokale integratie die nu gebouwd wordt buiten het centrale platform, is straks een legacy-probleem. De organisatie die over twee jaar wil opschalen naar enterprise AI, betaalt dan dubbel.
De vraag is niet meer: “Wanneer beginnen we met AI?”. De vraag is: “Wie is er verantwoordelijk voor wat er al draait?”.