Gradient blur
Blog
Intelligence artificielle
Données et Analyses
Services gérés
Retour à l'apercu

La prolifération de l'IA : le shadow IT de 2026

Si vous avez observé vos collègues ces derniers mois, vous l'avez peut-être déjà remarqué vous-même : les outils IA surgissent partout. ChatGPT sur l'ordinateur portable de l'analyste financier, un agent maison connecté à des systèmes internes dont l'IT connaît à peine l'existence, et un assistant IA gratuit qui traite des données RH sensibles sans que personne ne sache où elles atterrissent.
09 - 04 - 2026

En tant que Data & Analytics Business Lead chez Xylos, je vois ce schéma quotidiennement dans les organisations que nous accompagnons.

Qu'est-ce qui déraille exactement lorsque l'adoption de l'IA échappe à tout contrôle, et comment construire un environnement que les collaborateurs utilisent volontiers, mais qui reste également sûr et gérable pour l'IT ?

Le schéma est désormais reconnaissable, mais il se présente différemment de ce que vous pourriez penser.

Oui, il y a eu un taskforce. Une équipe enthousiaste, une instance Azure OpenAI, un chatbot qui répond aux questions sur les documents internes. Trois mois plus tard, peut-être même une démo pour la direction. Et ensuite ?

Car entre-temps, votre analyste financier a construit son propre GPT qui fonctionne sur des fichiers Excel exportés du trimestre précédent. Votre équipe marketing travaille avec trois outils IA différents, aucun identique. Un développeur a construit un agent vibe-codé connecté à une bibliothèque SharePoint qui n'a plus été synchronisée depuis six mois. Et votre responsable RH interroge des informations sensibles sur le personnel via un chatbot gratuit dont personne ne sait où vont les données.

Le pilote n'a pas échoué. Le pilote s'est multiplié, mais sans gestion, sans gouvernance, sur des données que personne n'a validées.

Ceci n'est pas l'histoire d'organisations qui prennent du retard sur l'IA. Ceci est l'histoire d'organisations où l'IA est déjà profondément ancrée dans le travail quotidien, sans que personne n'ait pris de décision à ce sujet. Les collaborateurs n'ont pas attendu de stratégie. Ils ont simplement commencé. Et aujourd'hui, la prolifération est un fait : des dizaines d'intégrations locales, autant de points de contamination des données, et une visibilité centrale nulle sur ce qui se passe réellement.

Ce qui déraille concrètement, et pourquoi cela s'aggrave

Les problèmes liés à une adoption incontrôlée de l'IA ne sont pas hypothétiques. Ils sont déjà visibles dans des organisations qui, il y a deux ans, pensaient vouloir garder un œil sur la situation, ont mené des pilotes isolés, mais n'ont toujours pas élaboré de vision claire. Voici ce qui se passe concrètement :

-

Fragmentation des données

Chaque collaborateur alimente son outil IA avec les données qu'il peut lui-même trouver : exports, captures d'écran, copier-coller. Les résultats reposent sur des sources qui ne sont peut-être plus exactes, pas à jour, et surtout pas traçables.

-

Shadow IT à grande échelle

Des agents vibe-codés, des automatisations locales et des extensions de navigateur sont construits sans aucune implication de l'IT. Ils fonctionnent… jusqu'à ce qu'ils ne fonctionnent plus, et personne ne sait pourquoi ni comment les réparer.

-

Angles morts en matière de conformité

Des données sensibles telles que les données clients, les dossiers du personnel ou les documents juridiques sont partagées avec des services IA externes sans accord de sous-traitance, et encore moins de politique de classification des données.

-

L'incohérence des résultats comme nouvelle norme

Deux collaborateurs qui posent la même question à deux outils différents obtiennent deux réponses différentes. Personne ne sait laquelle est correcte. L'incertitude s'infiltre lentement dans la prise de décision, car ce qui était autrefois factuel repose désormais sur différents outils aux résultats différents.

-

Une dette technique impossible à combler

Chaque intégration locale construite aujourd'hui en dehors de la plateforme centrale deviendra plus tard un problème de legacy. L'organisation qui voudra passer à l'IA à l'échelle de l'entreprise dans deux ans paiera alors le prix fort.

La question n'est plus : « Quand commençons-nous avec l'IA ? ». La question est : « Qui est responsable de ce qui tourne déjà ? ».
La solution n'est pas une politique, c'est une plateforme

La réaction intuitive face à la prolifération est la réglementation : rédiger une politique IA, interdire les outils non approuvés, mettre en place un comité de gouvernance. Cela ne fonctionne pas. Les collaborateurs habitués aux gains de productivité de l'IA n'arrêtent pas simplement parce que les RH envoient une note de service.

La seule approche efficace consiste à offrir une meilleure alternative. Une plateforme au moins aussi accessible que les outils isolés que les gens utilisent aujourd'hui, mais construite sur des données fiables, dans le cadre de la gouvernance de l'organisation, et gérable par l'IT.

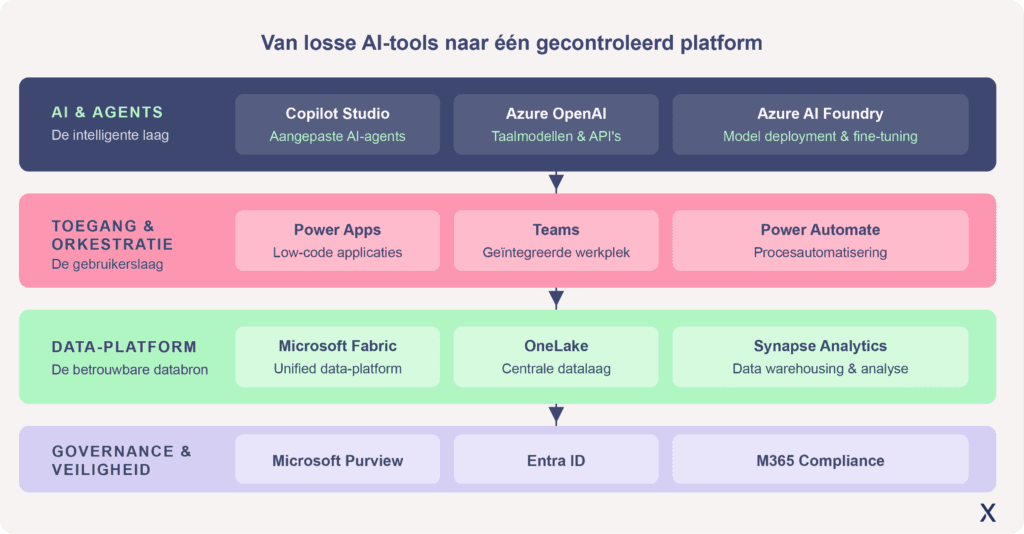
C'est précisément ce que Xylos rend possible, avec Microsoft Fabric et Copilot Studio comme piliers. Non pas pour remplacer ce que les gens font déjà, mais comme l'environnement contrôlé au sein duquel ils peuvent continuer à le faire.

La logique est simple : si les collaborateurs vont de toute façon construire des agents, donnez-leur Copilot Studio. S'ils vont de toute façon interroger des données, donnez-leur accès à un dataset Fabric fiable. Vous déplacez la prolifération vers un walled garden tout en gagnant en qualité, en sécurité et en évolutivité.

Microsoft Fabric : des données fiables comme fondation

Le problème fondamental derrière toute cette prolifération est le même : chacun travaille avec sa propre version de la vérité. Microsoft Fabric résout cela en regroupant toutes les sources de données au sein de votre tenant Microsoft dans une plateforme unifiée, avec OneLake comme couche de données centrale partagée par tous les autres services.

Ce que cela signifie concrètement : un agent Copilot construit sur Fabric puise toujours dans la même source de données certifiée et à jour. Plus d'exports Excel obsolètes. Plus de bibliothèques SharePoint qui accusent six mois de retard. Une seule version de la vérité, pour tout le monde, à tout moment.

Dans le même temps, Fabric s'intègre parfaitement à Microsoft Purview pour la gouvernance et la conformité des données, ce qui vous permet de voir exactement quelles données sont utilisées, pour quoi, par qui, et si cela respecte les règles en vigueur.

Copilot Studio : l'environnement contrôlé pour ce que les collaborateurs font déjà

Copilot Studio donne aux organisations la possibilité de construire des agents IA personnalisés (ou de les faire construire par les collaborateurs) au sein de l'environnement sécurisé de leur propre tenant Microsoft. Les agents se connectent aux données Fabric, aux bibliothèques SharePoint, à Dynamics 365 et à des systèmes externes via des connecteurs certifiés.

La différence avec ce qui se passe aujourd'hui à l'état sauvage est cruciale : tout ce qui est construit dans Copilot Studio est visible pour l'IT, auditable via Purview, et relève de la gestion des identités et des accès d'Entra ID. Le collaborateur qui souhaite construire un agent pour son équipe peut le faire, mais pas en dehors du champ de vision de l'organisation.

C'est le basculement de la prolifération vers une innovation contrôlée. Non pas en interdisant, mais en offrant une meilleure alternative que les gens ont réellement envie d'utiliser.

Cela exige plus que de la technologie

Mettre en place un environnement Fabric et déployer Copilot Studio ne résout pas automatiquement la prolifération. Ce qu'il faut, c'est une combinaison que beaucoup d'organisations n'ont pas aujourd'hui : des data engineers qui construisent et gèrent l'architecture Fabric, des architectes IA qui conçoivent des agents alignés sur de véritables processus métier, et des accompagnateurs d'adoption qui aident les collaborateurs à passer de leur outil isolé habituel à la plateforme centrale.

Les organisations disposant d'une base M365 solide ont ici une longueur d'avance qu'elles exploitent rarement. Les structures de gouvernance sont en place. La gestion des identités est en ordre. Les utilisateurs connaissent l'environnement Microsoft. Ce qui manque, c'est la couche de connexion : l'expertise pour enrichir cette infrastructure existante avec du data engineering et une architecture IA qui évolue réellement.

Dans le prochain article, nous montrerons comment Power Apps fait office de porte d'entrée concrète: la technologie que votre équipe actuelle connaît déjà, et qui peut faire le lien plus vite que prévu vers une IA intégrée qui s'ancre réellement dans l'organisation.

Reconnaissez-vous cette prolifération dans votre organisation ? C'est alors le moment de poser l'architecture qui transforme le chaos en avantage concurrentiel. Contactez-nous pour un entretien sans engagement sur ce que signifie une intégration IA maîtrisée pour votre environnement Microsoft.

À propos de l'auteur

Peter Verrykt est Data & Analytics Business Lead chez Xylos et accompagne les organisations dans la transformation de la donnée en valeur business concrète. Il aide les entreprises à voir au-delà des implémentations techniques et à utiliser la donnée comme fondement de meilleures décisions, d'une plus grande agilité et d'une croissance durable.