Azure OpenAI, Copilot Studio, les bonnes directives suivies. Et pourtant, le résultat reste décevant. Où est le problème ? » Après une demi-heure de questions, c'était clair : le problème ne venait pas du modèle, mais des données. Des documents SharePoint obsolètes, des exports ERP dans Excel, et une base de connaissances avec plusieurs définitions qui coexistent. Tout était là. Rien ne fonctionnait vraiment ensemble. Le modèle faisait ce qu'il devait faire. Les données, non. En tant que Data & Analytics Business Lead chez Xylos, je vois ce schéma se répéter dans presque toutes les organisations qui veulent se lancer dans l'IA. C'est pourquoi cet article porte sur la couche de données : la fondation qui reçoit bien moins d'attention que le modèle, mais qui pèse bien davantage.
Ceci est le troisième article de notre série de blogs consacrée aux briques d'une approche IA évolutive au sein des organisations. Nous avons d'abord examiné la prolifération incontrôlée de l'IA dans les organisations. Puis le rôle du Power Platform comme pont vers une intégration IA maîtrisée. Cette fois, il s'agit de la fondation sous cette approche : la couche de données.
Le modèle est rarement le goulot d'étranglement
Un système intelligent n'est intelligent qu'à la hauteur des données sur lesquelles il fonctionne. Garbage in, garbage out, mais à l'échelle et avec une facture salée.
GPT-4, Llama, Mistral, Phi-3 : pour la plupart des cas d'usage en entreprise, les modèles actuels sont largement assez puissants. La différence entre une solution IA qui instaure la confiance et une solution qui génère de la frustration se situe généralement ailleurs.
Le véritable goulot d'étranglement se trouve dans ce qui se passe avant le modèle. Les données sont-elles disponibles ? Sont-elles à jour ? Tout le monde comprend-il les mêmes définitions ? Sait-on qui est propriétaire de la source sur laquelle repose le résultat ?
Prenons une entreprise de retail qui souhaite construire un assistant IA pour la prévision de la demande. Le modèle est prêt en quelques semaines. La connexion entre l'ERP, le WMS et les données de marché externes traîne pendant sept mois, car personne n'a jamais décidé comment ces flux se rejoignent, qui les gère et quelle version fait foi.
Ce n'est pas une exception. C'est le schéma habituel.
Un système intelligent tire sa valeur de la qualité du contexte sur lequel il travaille. Dès que ce contexte devient fragmenté, obsolète ou flou, l'erreur s'amplifie avec lui. Sauf que désormais, elle va plus vite, paraît plus convaincante et coûte plus cher.
Ce qu'une couche de données pour l'IA doit vraiment accomplir
Une couche de données n'est pas un espace de stockage où l'on rassemble tout en espérant que l'IA en fasse quelque chose de sensé. Elle doit répondre à quatre exigences à la fois.
1. Disponibilité. Les données pertinentes doivent être accessibles via une couche logique et cohérente, indépendamment de leur origine historique.
2. Qualité. Les données doivent être validées, documentées et gérées. Sans appropriation claire, la qualité devient une question de hasard.
3. Actualité. Les données doivent correspondre à la vitesse qu'exige votre cas d'usage. Pour certains scénarios, une mise à jour quotidienne suffit. Pour d'autres, il faut du quasi temps réel.
4. Gouvernance. Vous devez savoir qui a accès à quelles données, pourquoi, et si cela correspond à votre politique et à vos obligations de conformité.
Sur le papier, cela semble évident. Dans la pratique, nous constatons que dans la plupart des organisations, au moins un de ces quatre piliers est sous pression. Souvent plus d'un à la fois.
Pourquoi Fabric change la donne
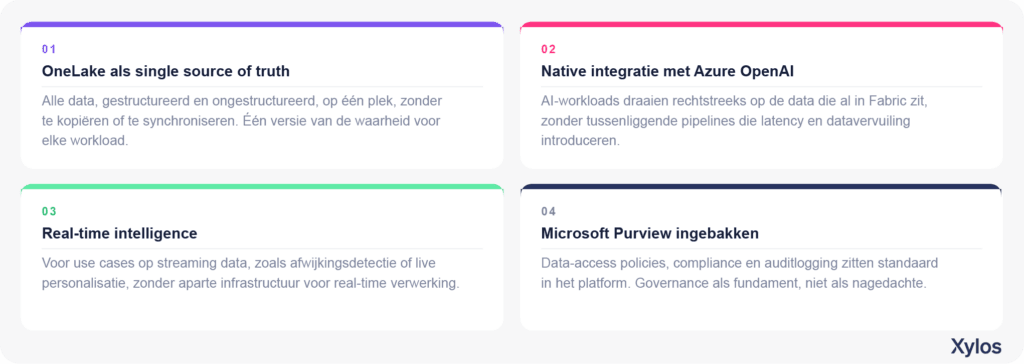
Microsoft Fabric change cette donne car il part de l'intégration plutôt que de la fragmentation. Là où les données étaient autrefois réparties entre des outils distincts pour l'intégration, l'ingénierie, l'entreposage, la BI et la gouvernance, Fabric rassemble ces couches au sein d'une seule plateforme, avec OneLake comme socle partagé.
Cela a un impact direct sur l'IA. Dès que vos données ne doivent plus transiter par des exports séparés, un stockage en double et des connexions improvisées, la fiabilité de ce qu'un système IA récupère et génère augmente. Vous réduisez la latence, limitez la pollution des données et faites de la gouvernance un élément structurel plutôt qu'un ajout après coup.
Pour les cas d'usage qui doivent réagir plus vite, Fabric ajoute aussi des capacités natives autour de la real-time intelligence. Et avec Purview comme couche intégrée pour les politiques, la conformité et l'auditabilité, la visibilité fait enfin partie intégrante de la fondation.
Cette nuance reste importante : Fabric est un catalyseur, pas une solution miracle. Les organisations n'en tirent vraiment parti qu'une fois qu'elles ont clarifié à quoi ressemble leur modèle de données, quels domaines existent et qui porte la responsabilité de quoi. Fabric rend une bonne stratégie exécutable. Il ne la remplace pas.
Pourquoi le lakehouse devient l'architecture IA logique
Le glissement vers l'architecture lakehouse n'est pas un effet de mode. Il découle directement de ce que l'IA exige des données.
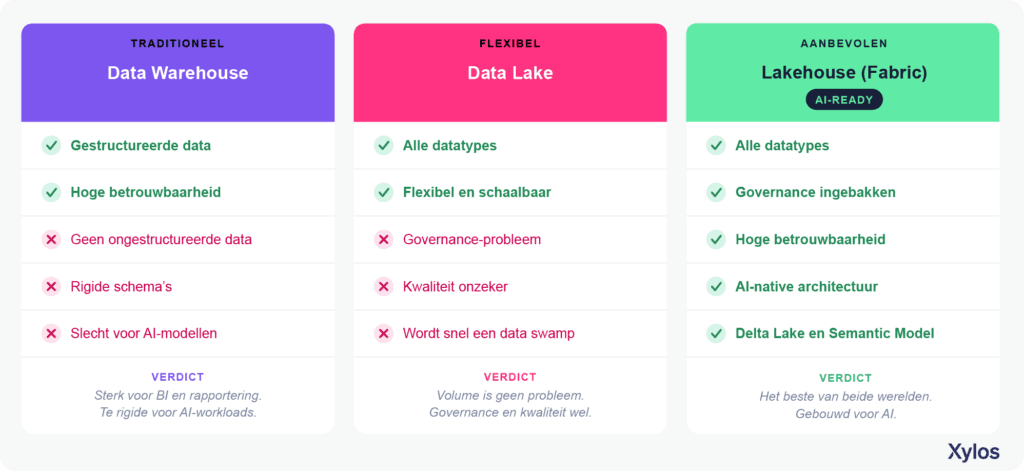
Un data warehouse classique excelle dans les analyses structurées et historiques. Cela reste précieux pour le reporting et le pilotage. Mais il atteint plus vite ses limites dès que l'IA doit aussi intégrer du texte, des documents, des images ou des données d'événements. Un data lake gère mieux ce volume, mais sans structure suffisante, il risque de dégénérer en un environnement où tout semble disponible sans que personne ne sache plus ce qui est fiable.
Le lakehouse réunit ces deux mondes. La flexibilité d'un lake. La fiabilité et la maîtrise d'un warehouse. C'est précisément cette combinaison qui en fait une base adaptée aux workloads IA modernes, où données structurées et non structurées forment ensemble le contexte pour les agents, copilots et applications analytiques.
Trois recommandations concrètes pour votre organisation
1. Commencez par un audit des données
Pas pour ranger un inventaire dans un tiroir, mais pour cerner précisément quelles données vous avez réellement, où elles se trouvent, à quel point elles sont à jour et qui les gère. Cela met presque toujours au jour des points de friction jusque-là invisibles.
2. Définissez d'abord votre stratégie de données
Choisir une technologie sans clarté sur les domaines, les définitions et la propriété des données mène rarement à une accélération. En général, on construit alors plus vite sur une fondation qui n'est pas encore assez stable.
3. Traitez la gouvernance comme un accélérateur de croissance
La gouvernance est encore trop souvent perçue comme un frein ou une obligation. En réalité, elle permet aux cas d'usage IA d'être déployés plus vite, précisément parce que la confiance, l'accès et le contrôle sont réglés en amont.
Les organisations qui feront la différence avec l'IA dans les années à venir ne sont pas nécessairement celles qui expérimentent en premier un nouveau modèle. Ce sont celles qui mettent aujourd'hui de l'ordre dans leur fondation de données.
La vraie question pour la prochaine étape
C'est aussi le cœur de cette histoire : un agent qui accède au mauvais contexte reste tout aussi peu fiable, aussi intelligent le modèle paraisse-t-il.
Chez Xylos, nous aidons les organisations à s'atteler précisément à cela : de l'évaluation des données à l'architecture lakehouse et à l'implémentation de Fabric, en partant toujours de la valeur business qu'une solution doit générer. Contactez-nous pour une évaluation de données sans engagement. Nous cartographions où vous en êtes aujourd'hui, où se situent les principaux écarts et quelles étapes offrent le meilleur rendement.
Dans le prochain article, nous irons encore plus loin. Nous verrons comment relier cette fondation de données à un output IA fiable et vérifiable : le grounded AI, et l'architecture que cela requiert.
À propos de l'auteur
Peter Verrykt est Data & Analytics Business Lead chez Xylos et accompagne les organisations dans la transformation des données en valeur business concrète. Il aide les entreprises à regarder au-delà des implémentations techniques et à utiliser les données comme fondation pour de meilleures décisions, plus d'agilité et une croissance durable.